Machine Learning: Oltre le basi e verso l'AGI
Il Machine Learning (ML) ha smesso di essere una promessa futura per diventare il motore pulsante di innumerevoli settori: finanza, medicina, logistica e persino arte creativa. In questo articolo ci spingeremo oltre le introduzioni tradizionali—come i classici modelli di regressione lineare o gli alberi decisionali—per esplorare le architetture avanzate che stanno attualmente guidando l’innovazione.
La nostra discussione toccherà argomenti chiave, tra cui le architetture moderne, i processi di apprendimento intrinsechi dei modelli di grandi dimensioni e le sfide di ottimizzazione.
Architetture di Deep Learning Moderne
Fino a pochi anni fa, le reti neurali convoluzionali (CNN) dominavano il campo della computer vision, mentre le reti neurali ricorrenti (RNN) o le LSTM erano lo standard per l’elaborazione del linguaggio naturale (NLP). Oggi, il panorama è stato completamente rivoluzionato dai Transformer.
Questi modelli innovativi si basano su un meccanismo chiamato self-attention, che consente di processare enormi quantità di dati in parallelo anziché sequenzialmente. Questa rivoluzione architettonica è alla base dei moderni Modelli Linguistici di Grandi Dimensioni (LLM) come GPT-4, Claude e Llama.
Il Meccanismo di Self-Attention in Sintesi
Il vero segreto dietro l’incredibile efficacia dei modelli Transformer è la loro capacità di pesare l’importanza di ciascun frammento di input (come una parola in una frase) rispetto a tutti gli altri, indipendentemente dalla loro distanza.
Matematicamente, l’attenzione viene calcolata tramite la seguente operazione vettoriale:
$$ Attention(Q, K, V) = softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)V $$
In questa equazione:
- Q (Query): Rappresenta ciò che il sistema sta attualmente analizzando.
- K (Key): Funge da indice per le informazioni disponibili nel contesto.
- V (Value): Contiene i dati effettivi che verranno elaborati.
Questa operazione permette al modello di comprendere in modo sfumato il contesto a lungo termine e le dipendenze complesse.
Il Processo di Addestramento di una Rete Neurale
Per far sì che l’architettura diventi in grado di ragionare, il processo di addestramento è fondamentale. Nel Deep Learning, l’apprendimento emerge attraverso milioni di interazioni cicliche in cui i pesi della rete vengono progressivamente aggiornati.
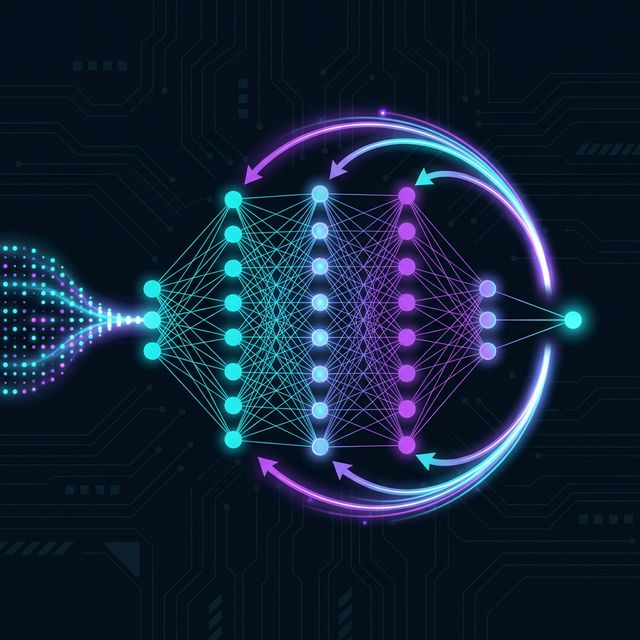
Come illustrato sopra, l’addestramento segue un flusso ben definito:
- Forward Propagation: I dati di input attraversano gli strati nascosti (hidden layers) subendo trasformazioni lineari e non lineari (es. funzioni di attivazione come ReLU o GELU).
- Loss Calculation: L’output generato dalla rete viene confrontato con il risultato atteso calcolando una funzione di errore (Loss function).
- Backpropagation: L’errore viene propagato all’indietro lungo tutta la rete calcolando i gradienti tramite la regola della catena matematica. Questo indica come modificare i singoli pesi.
- Ottimizzazione: Algoritmi come Adam o SGD utilizzano i gradienti per correggere la rete e minimizzare l’errore nel ciclo successivo.
Tecniche di Ottimizzazione Avanzate
L’addestramento di modelli mastodontici, con miliardi di parametri, richiede conoscenze algoritmiche specifiche e un’ingegnerizzazione al limite del possibile per evitare fallimenti catastrofici:
- Gradient Clipping: Intervento cruciale per limitare la grandezza dei gradienti durante la backpropagation, evitando la cosiddetta “esplosione” matematica che distruggerebbe l’apprendimento.
- Learning Rate Schedulers (es. Cosine Annealing): Il tasso di apprendimento non è statico. Inizia alto per esplorare rapidamente le soluzioni, per poi decrescere dolcemente (come la curva di un coseno) garantendo una convergenza stabile verso il minimo globale dell’errore.
- Mixed Precision Training (AMP): Utilizzare la precisione aritmetica a 16-bit (FP16 o BF16) per i calcoli matriciali veloci, riservando i 32-bit (FP32) solo per accumulare l’aggiornamento dei pesi. Questo approccio dimezza i tempi di training e il consumo cruciale della memoria VRAM delle GPU.
Il Futuro: RLHF e Verso l’AGI
Mentre per anni ci siamo basati sull’apprendimento supervisionato (che richiede immense basi di dati etichettate manualmente da esseri umani), l’orizzonte attuale è dominato dall’apprendimento semi-supervisionato e dal Reinforcement Learning from Human Feedback (RLHF).
L’RLHF è ciò che rende i moderni chatbot “docili”, sicuri e allineati alle aspettative umane. Combina le intuizioni della teoria dei giochi con una supervisione mirata, permettendo all’intelligenza artificiale di esplorare e allinearsi in tempo reale ai valori e alle dinamiche del dialogo umano.
La ricerca si sta inesorabilmente spingendo verso la fatidica Artificial General Intelligence (AGI) – macchine capaci di comprendere, apprendere e applicare la conoscenza trasversalmente in modo indistinguibile, o persino superiore, a un essere umano. Comprendere a fondo queste architetture avanzate è il primo passo essenziale per modellare il domani della computazione intelligente.