Il ruolo dell'AI Engineer nel 2026: Architetture e Deploy
Negli ultimi due anni, l’esplosione dei foundation models e delle API ad alte prestazioni (dalla famiglia GPT di OpenAI ai modelli open-source su Hugging Face) ha creato una rapida spaccatura settoriale. Ne è emersa una nuova figura professionale incredibilmente richiesta: l’AI Engineer.
A differenza del Data Scientist tradizionale o del Machine Learning Researcher – che si concentrano sull’esplorazione, la pulizia dei dati e la scoperta di nuove architetture di rete – l’AI Engineer si focalizza esclusivamente sull’ingegnerizzazione dello strato applicativo e sul deploy rigoroso in ecosistemi di produzione. Tradurre la potenza di un modello linguistico in un software capace di generare valore per migliaia di utenti simultanei è una sfida complessa.
Competenze Fondamentali: Il ponte tra AI e Software
Sebbene Python rimanga il dialetto assoluto dell’intelligenza artificiale, per diventare un AI Engineer è indispensabile dominare strumenti che vanno oltre la sintassi standard.
1. Ingegneria del Software e MLOps
Un LLM finché vive solo in uno script o in un notebook Jupyter ha un impatto pari a zero sul mondo reale. L’AI Engineer moderno lavora con pipeline robuste costruite attorno al ciclo di vita del modello (Machine Learning Operations):
- Containerizzazione e Orchestrazione: Strumenti come Docker e Kubernetes sono essenziali per servire i modelli in ambienti scalabili e cloud-native.
- Tracciabilità degli Esperimenti: Librerie come MLflow o Weights & Biases permettono di versionare sia il codice, sia i dataset e il peso dei modelli addestrati.
- Testing Continuato: Quando si aggiorna un prompt o si cambia l’LLM sottostante, è necessario avere una suite di evaluations automatizzate per garantire che le capability del prodotto non degradino.
2. Architetture RAG (Retrieval-Augmented Generation)
Uno dei compiti principali dell’AI Engineer contemporaneo è risolvere il problema delle limitazioni informative dei modelli pre-addestrati. Poiché un LLM non conosce i documenti interni di un’azienda, si ricorre all’architettura RAG.
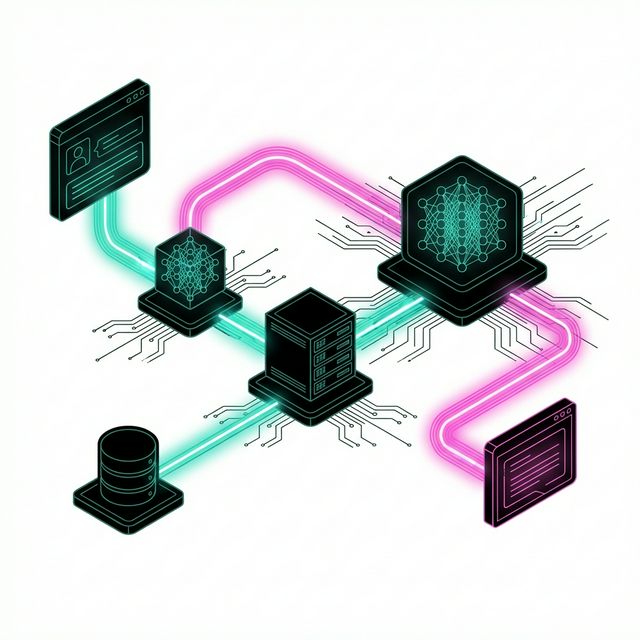
L’immagine sopra visualizza concettualmente il flusso di una struttura RAG efficace. Questa pipeline si divide in fasi ben distinte:
- Ingestion ed Embeddings: I documenti aziendali (PDF, database SQL, wiki) vengono “spezzati” (chunking semantico) e trasformati in vettori numerici (embeddings) che ne catturano il significato contestuale.
- Archiviazione: I vettori vengono salvati in speciali Database Vettoriali ad alte prestazioni come Pinecone, Qdrant o Milvus, ottimizzati per la ricerca di similarità.
- Retrieval e Generazione: Quando l’utente effettua una domanda, questa viene trasformata a sua volta in un vettore, confrontato con il database spaziale per recuperare il contesto esatto, per poi impacchettare tutto in un prompt che l’LLM utilizzerà per generare una risposta informata e priva di “allucinazioni”.
Questa orchestrazione tra base di dati, modello logico e interazione utente richiede precisione, riduzione della latenza e profonda conoscenza di framework orchestratori come LangChain o LlamaIndex.
3. Ottimizzazione e Quantizzazione in Edge Computing
L’inferenza di modelli pesanti in ambiente cloud costa parecchio. Un vero AI Engineer sa spingere l’ottimizzazione ai limiti operativi, riducendo le dimensioni dei modelli a fronte di una perdita di precisione minima o nulla.
- Quantizzazione (GGUF, AWQ): Passando dalla classica precisione dei numeri a virgola mobile a 32-bit (FP32) verso i formati a 8-bit o persino a 4-bit, permettendo l’esecuzione di potenti LLM locali anche su MacBooks o server economici.
- Inference Servers: L’adozione di software ottimizzati come vLLM o TensorRT-LLM massimizza i token generati al secondo sfruttando meccanismi avanzati come la PagedAttention.
La Sfida della Sicurezza
L’affidamento su meccanismi generativi introduce vulnerabilità software finora inesplorate: i Prompt Injections. Gli attacchi mirano a sovvertire le istruzioni base del bot (es. obbligando un assistente clienti a rivelare dati sensibili). Un AI Engineer si occupa di blindare l’architettura tramite layer di moderazione, input parsing stringente e testing automatico, garantendo che lo strato di connettività tra utente e Intelligenza Artificiale rimanga sicuro, resiliente e privo di bias comportamentali.